楽器を持ったまま、声でメトロノームを操作できます。表示設定で VOICE のボタンを選ぶと、画面の下にボタンが出ます。このボタンを押して(パソコンでは Shift+Space でも)「テンポ 120」「スタート」と言うと、そのとおりに動きます。
- 押すと聞き取りを始め、もう一度押すとやめる
声を文字にするのはブラウザの音声認識(Web Speech API)に任せています。この記事では、その先の「文字を、何の操作かに読み替える」部分を書きます。最初は言葉を探す決まりで読み替えましたが、独り言にも反応し、2 つの操作を一度に頼まれると読めませんでした。そこで、判定だけをする安いモデル Jev に、テンポ・再生などの操作ごとに問いを分けて聞くことにしました。
決まりで読み替えると、独り言にも反応した
最初は、文字の中の言葉を探して読み替えていました。「ストップ」「止め」が入っていれば止める、「速く」「上げ」なら BPM を上げる、「テンポ」と数があればその BPM にする、数が 1 つだけの文もテンポとみなす、という具合です。
試していると、「店舗を 120」でも BPM が 120 になりました。音声認識が「テンポ」を「店舗」と聞き違えたのですが、数が 1 つだけの文だったのでテンポとみなされ、たまたま思ったとおりに動いていました。
この決まりは、練習中の独り言にも当てはまってしまいます。「あと 5 分だけやろう」はテンポ 5(BPM の下限の 40 に丸める)、「3 回目だ」はテンポ 3 になります。「BPM を 130 にして再生して」のように 2 つの操作を一度に頼むと、片方しか読めません。
操作を軸に分けて、Jev に同時に聞く
Jev は、渡した文と問いに対して、選択肢ごとの確率を返すモデルです。AI への依頼の振り分けでも使っています(AI への依頼を Jev で分類して、モデルを使い分ける)。
「何の操作か」を 1 つの問いにすると、選択肢から 1 つしか選べないので、2 つの操作を一度に頼まれたときに表せません。そこで、テンポ・再生・トラックのそれぞれに別の問いを立て(この記事では軸と呼びます)、「アプリへの頼みか、独り言か」を聞く軸も加えて、1 回の呼び出しで同時に聞きます。
export const VOICE_CLASSIFIER_QUESTIONS = {
  tempo: {
    type: "choice",
    instructions: "What does it ask to do with the tempo (BPM)?",
    criteria: {
      set: "Set the tempo to a specific number.",
      faster: "Make the tempo faster or higher, by some amount or a little.",
      slower: "Make the tempo slower or lower, by some amount or a little.",
      none: "Does not ask to change the tempo.",
    },
  },
  playback: { /* start・stop・none */ },
  track: { /* next・previous・none */ },
  addressed: {
    type: "choice",
    instructions: "Is this a request to the metronome app?",
    criteria: {
      command: "A request or command to control the metronome (tempo, playback or tracks).",
      chatter: "Not a request to the app: talking to oneself, talking to someone else, counting, filler sounds, noise, or comments about the practice.",
    },
  },
} as const;「BPM を 130 にして再生して」なら、テンポは set、再生は start、トラックは none、頼みかどうかは command と返ります。
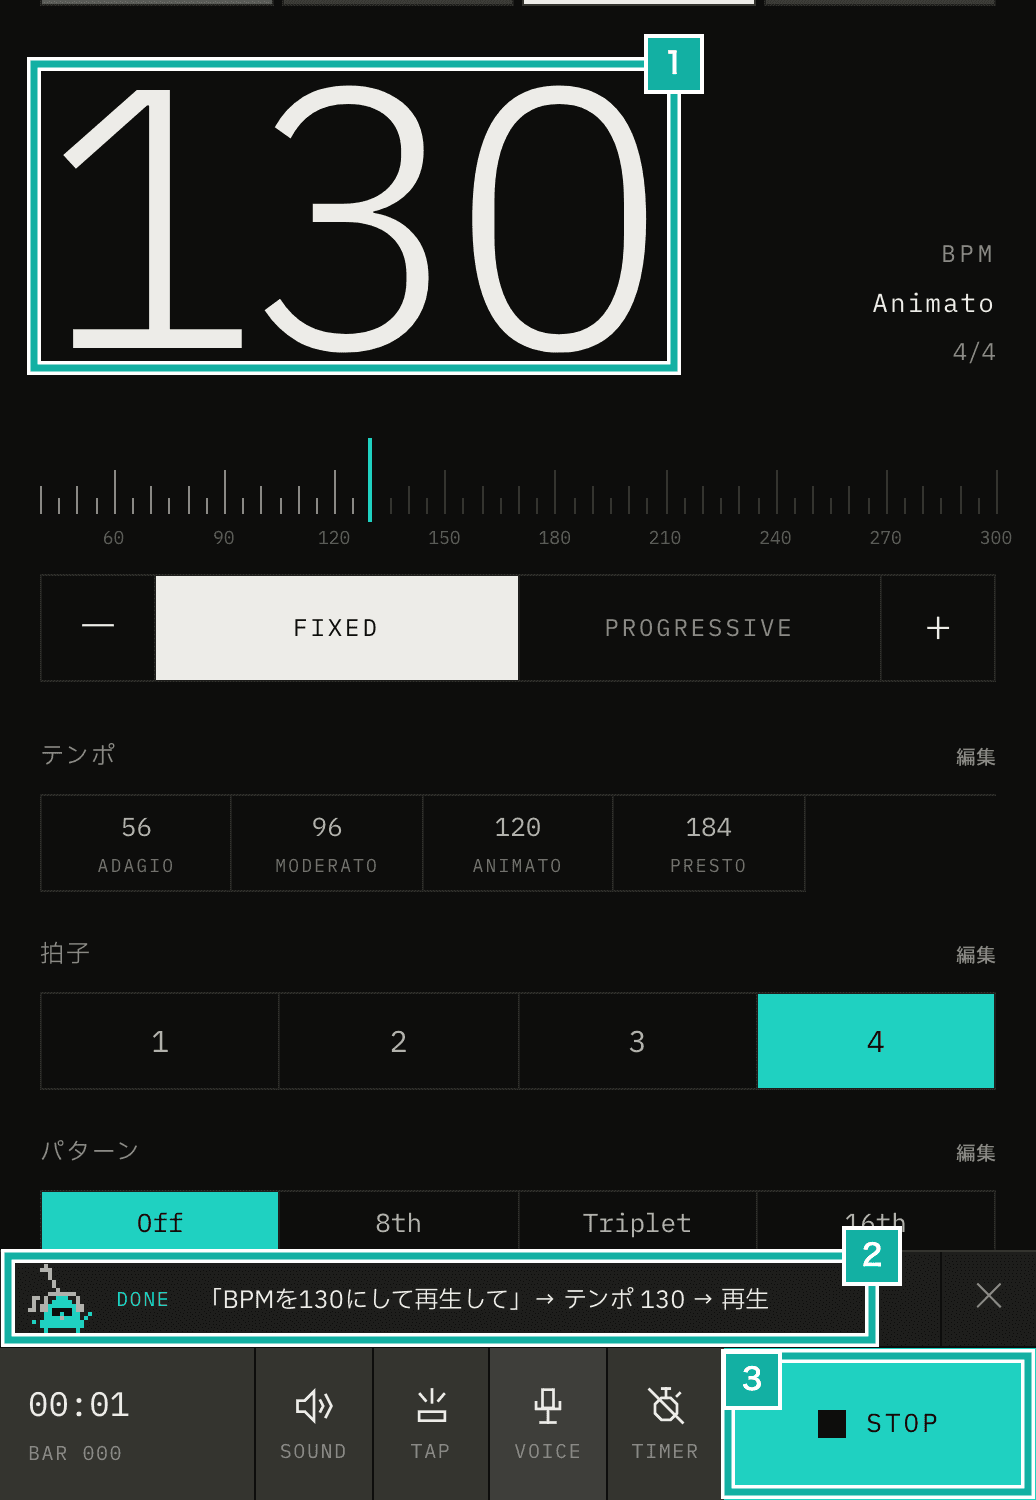
- BPM が 130 になった
- 聞き取った文字と、実行した操作を順に出す(しばらくすると閉じる)
- 再生が始まった
Jev は選択肢の確率を返すだけなので、数そのものは決まりで文から取り出します。算用数字・全角数字・漢数字(「百二十」)のどれでも読みます。数が 2 つ以上ある文(「3 番目の曲をテンポ 90 で」)のときだけ、見つけた数を選択肢に並べた問いをもう 1 つ加え、どれがテンポかを Jev に選ばせます。
bpm: {
  type: "choice",
  instructions: "Which number is the tempo (BPM) to set?",
  criteria: {
    ...Object.fromEntries(numbers.map((n) => [String(n), `The tempo is ${n}.`])),
    none: "None of the numbers is a tempo to set.",
  },
},64 個の言い方で試した
アプリに入れる前に、実際に言いそうな頼み方を 64 個用意して、Jev の答えを軸ごとの正解と比べました。
種類 | 数 | 結果 |
|---|---|---|
1 つの操作(日本語・英語) | 27 | すべて正解 |
聞き違い(「店舗を 120」「天保 120 にして」など) | 5 | 聞き違いの軽いもの 3 個は正解。「スタッフ」(ストップ)「再生死体」(再生して)は独り言と判定 |
2 つの操作を一度に頼む | 6 | すべて正解 |
数が 2 つある | 4 | テンポにする数は 4 個とも正解 |
独り言・会話・クリックの音を音声認識が拾った文 | 22 | すべて独り言と判定 |
3 回試したところ、すべての軸が正しかったのは、それぞれ 58 個・59 個・60 個でした。独り言を頼みと判定したものは、3 回とも 0 個です。
正解と違ったものの多くは独り言の文で、違っていたのは操作の軸だけでした。「このテンポきついな」はテンポが slower(0.91)と出ましたが、頼みかどうかの軸で独り言と判定されるので、何もしません。実行するのは頼みかどうかの軸が command のときだけで、そのうえで各軸とも確率が 0.7 以上の答えだけを使うことにしました。「BPM 120 で 2 小節後に」の再生(start が 0.38)のような、迷った答えを実行しないためです。
1 回の判定は、中央値で 0.3 秒ほどでした。最初の何回かだけ、1 秒ほどかかりました。
止める言葉と短い頼みは、Jev を待たない
「止めて」と言ってから 0.3 秒待つのは長すぎます。音声認識は、言い終える前にも途中の結果を返します。その中に「ストップ」「止め」などの言葉が出たら、Jev に送る前にその場でメトロノームを止め、残りの頼みだけを Jev の答えで実行します。
「スタート」「次の曲」「テンポ 120 にして」のような短い頼みも、Jev を待ちません。Jev に聞くのは、2 つの操作を一度に頼まれたときと独り言を見分けるためで、言い方が決まった短い頼みには、ほかの読み方がないからです。言った言葉の全体がこうした決まった言い方だけかを決まりで確かめ、そうであればそのまま実行します。
いくつもの操作は、止める → テンポ → トラック → 再生の順に実行します。「130 にして再生して」で、最初の 1 拍から 130 で鳴らすためです。
Jev を使えないときは、決まりに戻る
Jev はサーバーから呼びます。オフラインのとき、Jev を呼べる回数の上限(次の段落)を超えたとき、通信に失敗したときは、ブラウザの中の決まりだけで読み替えます。声の操作そのものは止めません。
1 回の判定は $0.00002 ほどなので、プランの回数には数えていません。乱用されたときの歯止めとして、聞き取りを始めるごとに 1 回と数え、利用者ごとに 1 時間 200 回、アプリ全体で 1 日 20,000 回($0.4 ほど)の上限を付けています。上限の確認は聞き取りを始めたときに行い、話しているあいだに済ませます。言い終えてから Jev の答えを待つ時間が、上限の確認のぶんだけ長くならないようにするためです。
Chrome は同じ結果を何度も届ける
試してすぐ、「再生して」と 1 回言っただけで、「再生」の知らせが 5 回ほど出ました。1 回の聞き取りで終える設定(continuous を false)にしていても、Chrome は同じ確定の結果を何度も届ける(onresult が何度も呼ばれる)ことがあります。届いた結果の番号を覚えておき、一度見た番号は飛ばすようにしました。
頼みを 1 つ言い終えたら、聞き取りを終える
聞き取り方も変えました。最初は、ボタンを押している間だけ聞いていました。スマホの音声入力に慣れていると押しっぱなしは手間なので、1 回タップすると聞き始め、頼みを 1 つ言い終えたら聞き取りを終えるようにしました。操作として読めない言葉だったときも、聞き続けずに終えて、読めなかったことを画面の下に出します。何も言わなければ 4 秒で終えます。
ボタンを押さずに、Metronome.fm のマスコットの名前で「ヘイ Friko」と呼びかけて始める合言葉も作っています(今はパソコンのブラウザだけで、アプリのメニューからオンにします)。端末の中で聞き分けるモデルを自分で学習させた話は「ヘイ Friko」の呼びかけを聞き分けるモデルを、自分で学習させたに、ブラウザで動かした話は「ヘイ Friko」を聞き分けるモデルを、画面を固めずにブラウザで動かすに書きました。