Metronome.fm には「AI に設定の編集を依頼」という機能があります。「テンポを 10 上げて」のように文章で頼むと、AI が今のメトロノームの設定を書き換えます。
AI のモデルを Gemini から OpenAI の gpt-5-mini に入れ替えるときに、届く依頼には性質の違うものが混ざっていることに気づきました。今の設定を少し直す依頼もあれば、「ベースがゴリゴリ動くファンクを作って」のように一から作らせる依頼もあります(Metronome.fm はクリックのほかに、拍ごとのベース音も鳴らせます)。メトロノームと関係のない文が届くこともあります。
1 つのモデルですべてを受けると、安いモデルでは一から作る依頼の出来が物足りず、高いモデルでは簡単な編集にまで高い料金を払うことになります。そこで、判定だけをする安いモデルで先に依頼を分け、依頼の種類ごとにモデルを替えることにしました。この記事では、依頼の分け方、モデルを選ぶために比べた結果、費用の抑え方を書きます。
依頼は 4 種類に分けた
届く依頼を、次の 4 つに分けました。
- 編集: 今の設定を直す依頼。「テンポを 10 上げて」「2 拍目と 4 拍目だけ鳴らして」「1 キー転調して」
- 一から作る: 雰囲気やジャンルで頼むもの。「バラードのロックなベース付きのかっこいいやつ」「ファンキーな 16 ビート」
- 曲を挙げる: 実在の曲を挙げて「〜みたいなの」と頼むもの
- 関係ない: メトロノームの設定と関係のない文。「今日の天気は?」「こんにちは」
編集は、今の設定の値を正しく書き換えられれば十分です。一から作る依頼と曲を挙げる依頼は、リズムやベースラインを作る力で出来が変わります。
Jev で依頼を分類する
分類には、TypeSafe AI の Jev を使いました。文章を生成せず、渡した文と問いに対して、選択肢ごとの確率を返すモデルです。料金は入力 100 万トークンあたり $0.042 で、出力は無料です。
AI の呼び出しはすべて Cloudflare AI Gateway を通し、料金は Cloudflare のクレジットからまとめて払っています。Jev もそこから呼べます。問いは 1 つで、答えを 4 つの選択肢(choice)から選ぶ形にし、それぞれの種類の説明を英語で書いて渡します。
export const createClassifierInput = (request: string) => ({
  state: `A user typed this request into the "edit settings with AI" box of a metronome app:\n${request}`,
  questions: {
    kind: {
      type: "choice",
      instructions: "What kind of input is this?",
      criteria: {
        edit: "Asks to change the metronome's settings: tempo (BPM), time signature, ...",
        create: "Describes a mood, genre or style of rhythm to build from scratch ...",
        song: "Asks for something like a specific existing song or artist's song ...",
        unrelated: "Not a request about metronome settings or rhythm at all: nonsense, ...",
      },
    },
  },
});返ってくるのは { edit: 0.97, create: 0.03, song: 0, unrelated: 0 } のような確率です。1 回の分類は平均 517 トークンで、$0.00002 ほど、0.35 秒ほどで返りました。
Jev は英語を前提にしているので、日本語の依頼を分けられるかを先に確かめました。32 個の依頼(編集 12・一から作る 6・曲を挙げる 5・関係ない 9)を流したところ、いちばん確率の高い選択肢が、こちらで付けた正解と合っていたのは 30 個でした。外れたのは、一から作る依頼の「速弾きの練習用に激しいやつ」と、曲名を挙げて「〜のテンポで」と頼んだ依頼の 2 個で、どちらも「編集」と判定されました。選択肢の並び順を入れ替えても、結果は変わりませんでした。
関係ない依頼は、回数を使わずに書き直しを促す
この機能には、プランごとに月の回数の上限があります。関係のない文で 1 回分を減らしてしまうのは、使う人にとって損です。
そこで、Jev が出した「関係ない」の確率が 0.9 以上なら、モデルを呼ばず、回数も使わずに、書き直しを促すメッセージを返すようにしました。32 個の依頼では、関係ない依頼 9 個の確率はどれも 0.99 以上でした。関係ある依頼で「関係ない」の確率がいちばん高かったのは、「初心者向けのやさしい練習メニュー」の 0.23 です。
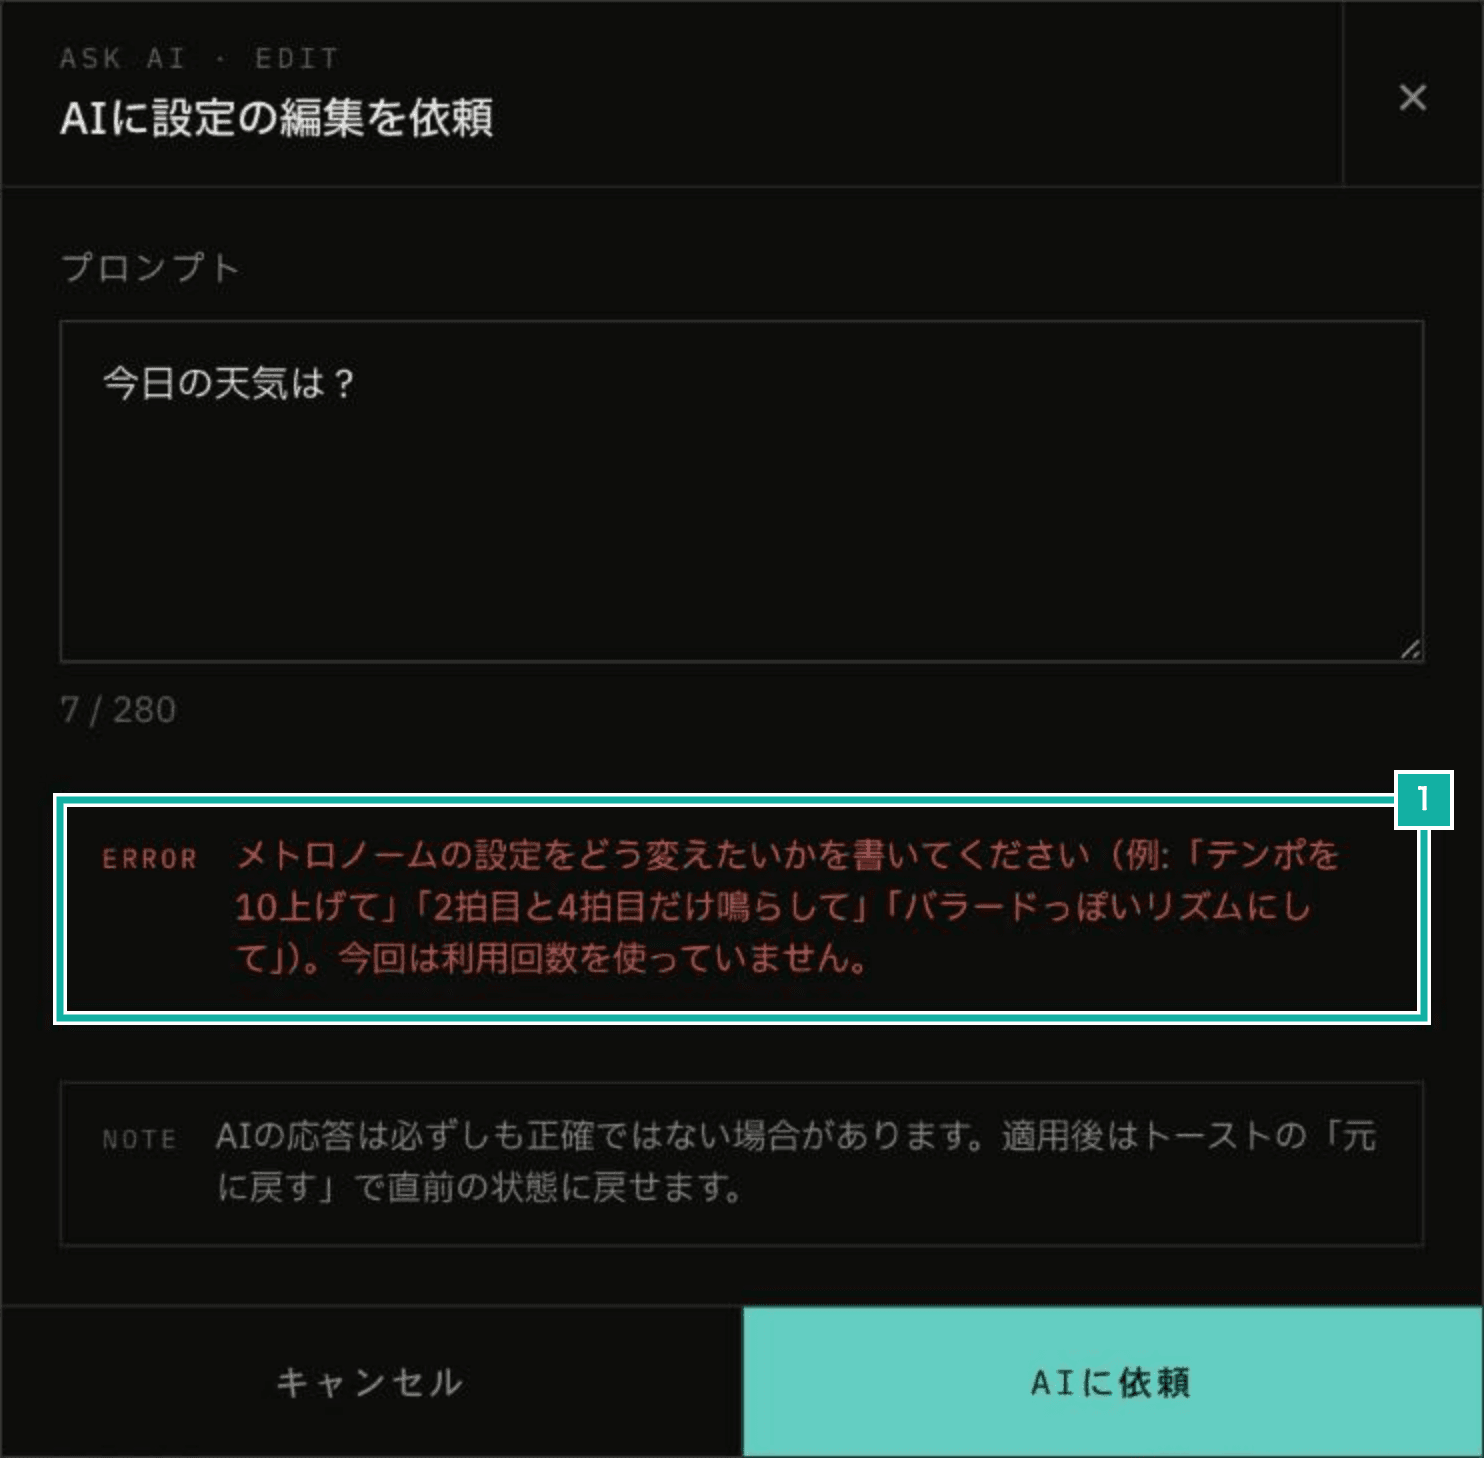
- 書き直しを促し、利用回数を使っていないことを伝える
境目を 0.9 と高めにしたのは、Jev が迷ったときにも高い確率を付けることがあると報告されているからです。関係ある依頼を断ってしまうと、その人は機能を使えません。逆に関係ない依頼を通してしまっても、モデルが「設定は変えられません」と返すだけです。判定を誤ったときの困り方がこれだけ違うので、断るのは確率がとても高いときだけにしています。
分類は回数を使う前に行うので、そのままでは依頼を連打されると、分類の費用だけがかさみます。そこで分類は 1 人あたり 1 時間に 30 回までとし、超えたら分類を飛ばして、ふつうの流れ(回数を使って gpt-5-mini に渡す)に任せます。分類に失敗したときも同じで、分類が原因で機能が使えなくならないようにしています。
一から作る・曲を挙げる依頼だけ、Claude Sonnet 5.5 に回す
モデルを選ぶために、一から作る依頼を 5 個(ファンクのマルチトラック・ロックバラード・ボサノバ・6/8 のロッカバラード・ドラムの 8 ビート)用意し、モデルと設定を変えた 4 通りで試しました。推論 low と effort low は、どちらも答える前にどれだけ考えるかの設定で、OpenAI と Anthropic とで呼び名が違います。
モデル | 平均の時間 | 1 回の費用 | 出力トークン | アプリが読める形で返った数 |
|---|---|---|---|---|
gpt-5-mini(推論 low) | 14.3 秒 | $0.0042 | 1,589 | 5/5 |
Claude Sonnet 5.5(effort low) | 4.9 秒 | $0.0195 | 503 | 5/5 |
Claude Sonnet 5.5(effort medium) | 6.9 秒 | $0.0218 | 732 | 4/5 |
Claude Opus 5.5(effort medium) | 15.8 秒 | $0.0538 | 1,240 | 5/5 |
できた設定はアプリに読み込んで、耳で聞き比べました。Sonnet 5.5 は、effort low・medium のどちらも思っていたより良い出来でした。
Sonnet 5.5 の effort low は、gpt-5-mini の 3 分の 1 の時間で返りました。費用は gpt-5-mini の約 4.6 倍ですが、Opus 5.5 の約 3 分の 1 です。effort medium は、6/8 の依頼で小節の外までパターンを書いてしまったので、low にしました。
一方、今の設定を直すだけの編集は、gpt-5-mini でも十分でした。編集の依頼を試す 25 個(テンポ・転調・拍子・ベース音の入れ方など)は、gpt-5-mini ですべて合格しています。Jev のいちばん確率の高い選択肢が「一から作る」か「曲を挙げる」のときだけ Sonnet 5.5 に回し、それ以外は gpt-5-mini のままにしました。
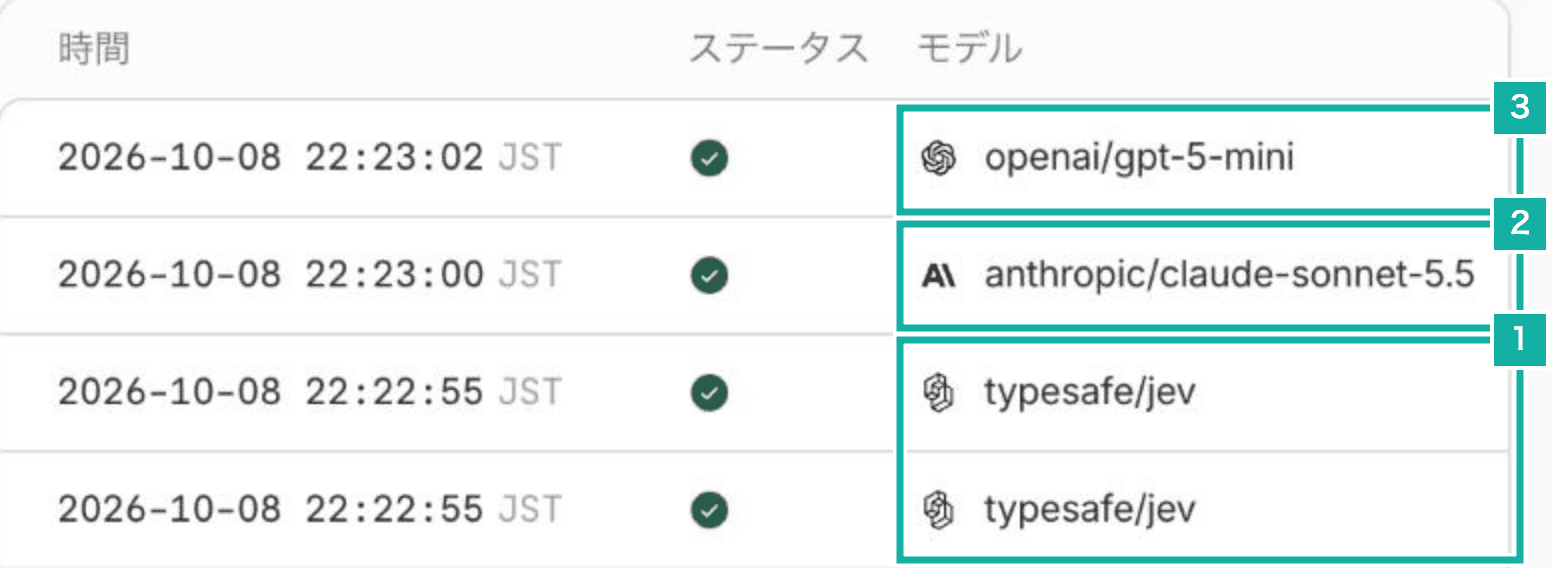
- 2 つの依頼を、それぞれ Jev で分類する
- 一から作る依頼(ロックバラード)は Claude Sonnet 5.5 へ
- 編集の依頼(テンポを上げる)は gpt-5-mini へ
振り分けた後に、編集・一から作る・曲を挙げる・関係ない依頼を合わせた 29 個を 3 回ずつ試し、87 回すべてが合格しました。合格の条件は、頼んだ内容が設定に表れていることと、アプリが読める形になっていることです。Sonnet 5.5 に回ったのは 12 回で、平均 6.0 秒でした。
費用を頭打ちにする
Sonnet 5.5 は 1 回 $0.02〜0.04 かかります。一から作る依頼ばかりを大量に送られると、費用がかさみます。
そこで、Sonnet 5.5 を呼べる回数に、アプリ全体で 1 日 300 回の上限を付けました。Pro とそれ以外で別々に数え、超えたら止めずに gpt-5-mini に回します。乱用されても、Sonnet 5.5 の費用は 1 日あたり $25 前後(300 回 × 2 × 約 $0.04)で止まります。
export const shouldUseCreativeModel = async (
  kind: string | null,
  tier: PlanTier,
): Promise<boolean> => {
  if (kind !== "create" && kind !== "song") return false;
  try {
    const { success } = await getDailyGlobalCreativeAiRatelimit().limit(
      tier === "pro" ? "pro" : "free",
    );
    return success;
  } catch (error) {
    logServerWarning("Creative AI limit check failed", error);
    return false;
  }
};1 人が Pro の月の上限の 50 回を使ったとして、1 回あたりの実測から費用を見積もると次のとおりです。
使い方 | 月の費用(見積もり) |
|---|---|
すべて gpt-5-mini | 約 $0.2 |
すべて Sonnet 5.5 | 約 $1.0〜1.3 |
振り分け(一から作る・曲を挙げる依頼が 3 割の場合) | 約 $0.4 |
振り分けにすると、すべてを Sonnet 5.5 にした場合の 3 分の 1 ほどで済みます。
見送ったモデル
- Claude Opus 5.5: Sonnet 5.5 の約 2.8 倍の費用で、3 倍以上遅くなりました
- Claude Haiku 5.5: 料金は Sonnet 5.5 の 20 分の 1 です。ただ、出たばかりで、試した時点では Cloudflare のクレジット払いに対応していませんでした。Anthropic の API キーを自分で用意して Cloudflare に登録すれば使えますが、支払いがクレジットと別になるので見送りました
- DeepSeek: 料金は安いものの、Cloudflare 経由では自分の API キーを登録する形でしか使えません。データの保存先も中国になるので見送りました
分類と出来を、試験で確かめ続ける
Cloudflare 経由では、Jev の版を固定できません。モデル名は typesafe/jev だけが通り、中身は最新の版に入れ替わります。そのため、分類を試すスクリプト(pnpm run eval:ai-classify)を残し、断る境目が今も合っているかをときどき確かめます。
編集の出来も、29 個の依頼を本番と同じ振り分けで試すスクリプト(pnpm run eval:ai-edit -- --route)で見ています。プロンプトや、モデルに渡す設定の項目の説明を直したときは、直す前と合格の数を比べます。1 回試すと $0.4 ほどかかります。