メトロノームの拍を、声で「いち、に、さん、し」「one, two, three, four」と数えられるようにしました。クリックに重ねて鳴らせば、画面を見なくても今が何拍目かがわかります。クリックの代わりに声だけで数えることもできます。
声は、TTS(音声合成)で前もって作った音源を、アプリで鳴らしています。作る途中で、数ごとに抑揚がばらばらになる問題と、声が拍より遅れて聞こえる問題に当たりました。この記事では、設定と鳴らし方に続けて、TTS の選び方と、その 2 つをどう直したかを書きます。
設定
画面の下の帯にある SOUND を押すと、オーディオ設定が開きます。ここに「声で数える」の欄を設けました。オフ・クリック+声・声だけの 3 つから選び、数えるときは声の言語(英語・日本語)も選びます。
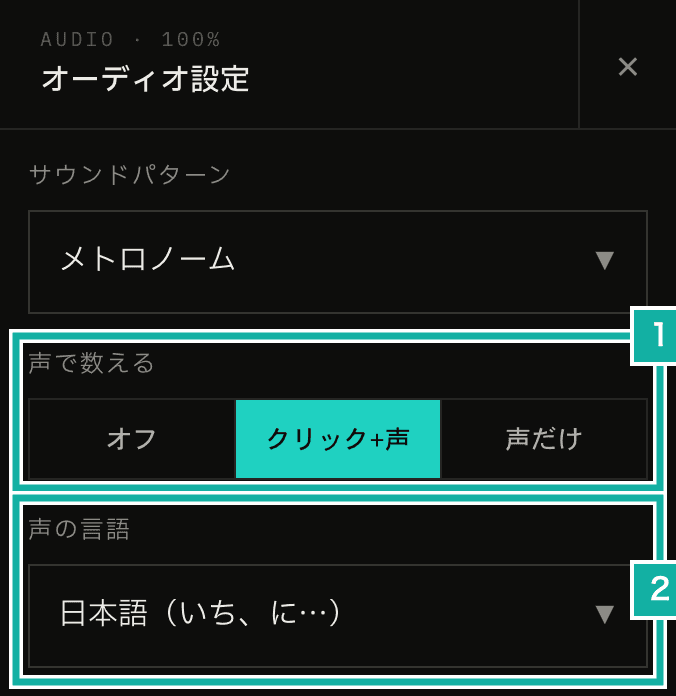
- 声で数えるか。クリックに重ねるか、クリックの代わりに声だけにするかを選ぶ
- 声の言語。初めて数えるときは、画面の表示言語を選んでおく
作り始めたときは、言語を選ぶ欄(オフ・英語・日本語)と「クリックの代わりに声だけ」のスイッチの 2 つに分けていました。ただ、「声だけ」は実質、クリックの音色を声に変える選択です。それを別のスイッチにすると、鳴らし方の設定が 2 か所に分かれて見えます。そこで、どう鳴らすかを 3 択にまとめ、言語はその下で選ぶようにしました。
声を、音色を選ぶサウンドパターンの 1 つにする案もありました。ただ、そうするとクリックと声を重ねられなくなります。クリックは立ち上がりが鋭く、拍の位置を正確に示せます。一方、声は子音のぶん立ち上がりが柔らかくなります(あとの節で書きます)。拍の位置はクリックで取り、何拍目かは声で知るのがいちばん使いやすいと考え、サウンドパターンとは別の設定にしました。
声だけにしたときに消すのは、各拍の頭で鳴るクリックだけです。ガイド音(8 分や 16 分の裏の音)と、クリックに重ねる低いベース音は鳴らします。ミュートした拍では数えません。
オーディオ設定の中の詳細設定では、声の音量と、声を左右どちらに出すかも選べるようにしました。
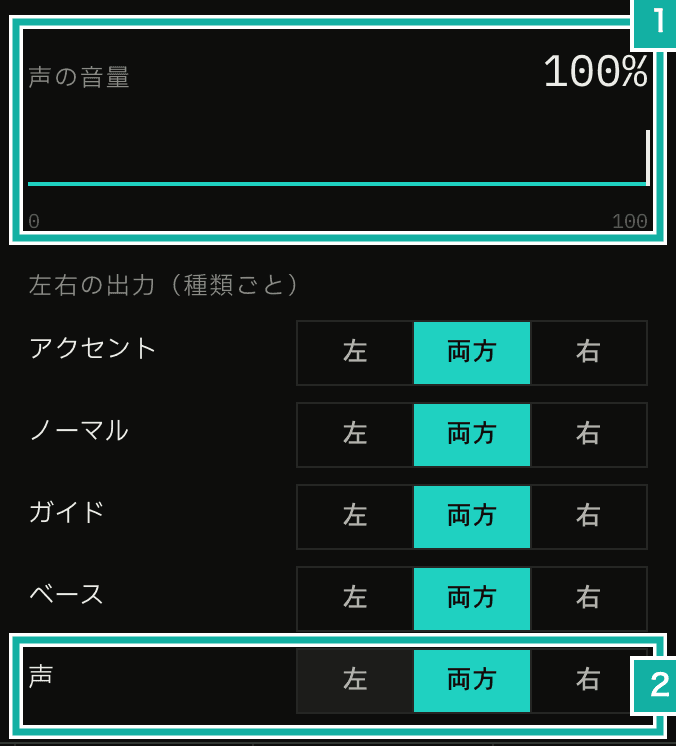
- 声の音量
- 声を左右どちらに出すか
声は音源にして、クリックと同じく AudioWorklet で鳴らす
ブラウザには speechSynthesis(Web Speech API)があり、読み上げるだけならこれで済みます。ただ、話し始めるまでの遅れが端末や声によって違い、拍に合わせられません。そこで、1〜16 の数え声をあらかじめ mp3 の音源にしておき、クリックの音源と同じく AudioWorklet で鳴らすことにしました。音源の作り方は、次の節から書きます。
声は数が大きいほど長くなります。「じゅういち」は 0.47 秒あり、速いテンポでは次の拍の声に重なります。そこで、次の声が鳴り始めたら、前の声を 15ms でフェードして切るようにしました。
// 新しく鳴らす声より前に始まった声を、新しい声の鳴り始めで短くフェードして切る
export const chokeVoiceCounts = (
  voices: Voice[],
  incoming: Voice[],
): Voice[] => {
  const starts = incoming
    .filter((voice) => voice.isVoiceCount)
    .map((voice) => voice.startTime);
  if (starts.length === 0) return voices;
  return voices.map((voice) => {
    if (!voice.isVoiceCount) return voice;
    const cutAt = Math.min(
      ...starts.filter((start) => start > voice.startTime),
    );
    if (!Number.isFinite(cutAt) || cutAt >= voice.endTime) return voice;
    const fadeStart = Math.max(
      voice.startTime,
      cutAt - VOICE_COUNT_CHOKE_SECONDS,
    );
    return {
      ...voice,
      endTime: cutAt,
      envelopes: [
        ...voice.envelopes,
        [
          { time: fadeStart, value: 1, curve: "set" },
          { time: cutAt, value: 0, curve: "smooth" },
        ],
      ],
    };
  });
};メトロノームの音を MP3 のファイルにする「MP3 の書き出し」でも、同じ切り方で声を入れています。
TTS を選ぶ
声を録音する手間を省くため、TTS で作ることにしました。このアプリの AI の機能は、Cloudflare AI Gateway を通して呼んでいます。料金は Cloudflare のクレジット(Unified Billing)から払っていて、OpenAI などの各社の API キーは持っていません。TTS も、ゲートウェイを通してクレジットで払えるものから試しました。
最初は OpenAI の TTS(/audio/speech)を考えました。ところが、チャットのモデルは Unified Billing で呼べるのに、音声の API は「API キーがない」という 401 で断られました。Unified Billing では TTS の料金を払えないようです。
次に、Workers AI の TTS を試しました。英語は Deepgram の Aura-2 で作れました。日本語を話せるモデルは MeloTTS だけでしたが、日本語の声は崩れていて使えませんでした。
最後に、2026 年 9 月に正式版(GA)になった Gemini 3.8 Flash TTS(gemini-3.8-flash-tts)を試しました。これもゲートウェイ経由では、テキストのモデルは通るのに TTS は 403 で断られたので、Google AI Studio で API キーを発行し、Google に直接送っています。無料枠は 1 分に 3 回・1 日に 10 回までで、作り直しを含めると足りなかったため、課金を有効にしました。なお、声は生成スクリプトで一度作れば済むので、アプリを使っているあいだに TTS を呼ぶことはありません。
1 語ずつ作ると、数ごとに抑揚がばらばらになる
最初は「いち」「に」と 1 語ずつ TTS に渡して作りました。どの語も正しく読めていましたが、並べて聞くと抑揚がひどく、数ごとに高さや調子がばらばらでした。
1 語だけを渡すと、TTS はそのたびに「単語を 1 つ読み上げる」抑揚をゼロから決めているようです。人が数えるときのように、続けて読む流れの中で調子がそろう、ということが起きないのだと考えました。
そこで、1〜16 を 1 回で続けて読ませ、無音の位置で 16 個に切り分けるように変えました。指示は、体操やトレーニングの掛け声として、どの数も同じ高さ・同じ調子・同じ強さで短く言い切り、数と数のあいだに同じだけ間をあける、というものです。日本語の読み方も掛け声に合わせ、4 は「し」、7 は「しち」、9 は「く」にしました。声は、Gemini の声の中で明るいとされている Zephyr にしています。
{
  "model": "gemini-3.8-flash-tts",
  "input": [
    {
      "type": "user_input",
      "content": [
        {
          "type": "text",
          "text": "いち、に、さん、し、ご、ろく、しち、はち、く、じゅう、…、じゅうろく",
          "annotations": [
            {
              "type": "speech_metadata",
              "style": "体操やトレーニングの掛け声。明るく元気に、一定のテンポで数を数える。…"
            }
          ]
        }
      ]
    }
  ],
  "response_format": { "type": "audio" },
  "generation_config": { "speech_config": [{ "voice": "Zephyr" }] }
}返ってくる録音は、数と数のあいだに 0.3〜0.8 秒ほどの無音が入ります。
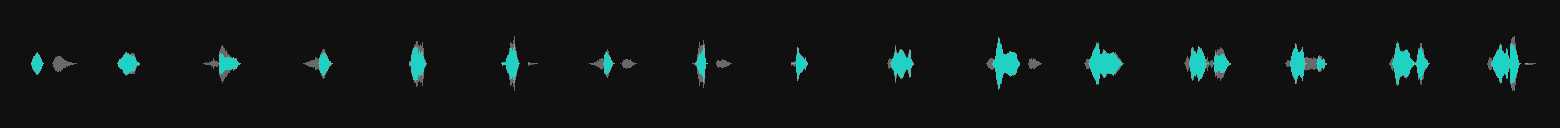
語の中にも、「い|ち」「ろ|く」のように子音の手前で 0.1 秒ほど音が途切れるところがあります。なので、0.25 秒以上の無音だけを区切りにしました。16 個にならなければ作り直します。
音量は語ごとにはそろえず、録音全体でいちばん大きいところ(ピーク)を基準に、まとめて上げ下げしました。語ごとにそろえると、続けて読んだときの自然な強弱が崩れるためです。
文字起こしで確かめる
切り分けた語は、Workers AI の Whisper で文字起こしして、狙った数に聞こえるかを機械で確かめています。
ここでは Whisper の空耳に悩まされました。「ご」「く」のような 0.2 秒ほどの音だけを渡すと、「ご視聴ありがとうございました」と返ってきます。Whisper が、ほとんど音のない入力に返しやすいことで知られる決まり文句です。前後に 0.5 秒の無音を足してから渡すと、出なくなりました。
それでも外れる語は、同じ音の別の字に書き起こされていました。「じゅうし」が「重視」、「ご」が「GO!」、「し」が「C」になるなどです。音は合っているので、生成スクリプトにある、語ごとに正解として認める書き起こしの一覧に、これらの字も入れています。
子音のぶん、声が拍より遅れて聞こえる
できた声を聞いてみると、「さん」だけが拍より遅れて聞こえました。
音源は頭の無音を詰めて、音が始まる点を拍に合わせています。ただ、「さん」は「s」の摩擦音が小さな音で 100ms ほど続いてから、「あ」の母音が来ます。耳は母音のところを拍として聞くため、そのぶん遅れて感じられました。音の大きさが、ピークより 20dB 小さいところ(-20dB)に初めて届く時点を測ると、ほかの語は 0〜30ms なのに「さん」だけ 110ms でした。
そこで、母音より前に残す子音を 30ms までにし、それより前は切って 5ms でフェードインするようにしました。摩擦音はほぼ一定の雑音なので、前を切っても、残した 30ms とフェードで自然につながります。
これで「さん」は直りましたが、今度は「し」が遅れて聞こえました。「し」の「sh」は「s」より強く、母音と同じくらいの大きさがあります。音全体の大きさで測ると、子音だけで -20dB の基準を超えてしまい、問題がないように見えていました。
母音は 1kHz より下に力があり、摩擦音や息の音は高い音に寄っています。そこで、1kHz 以下に絞った音の立ち上がりで、母音の始まりを測り直しました。
// 母音の立ち上がり。1kHz 以下に絞った音の 5ms ごとの RMS が、そのピークから -20dB に届く点
const pcm = execFileSync("ffmpeg", [
  "-i",
  file,
  "-af",
  "lowpass=f=1000,lowpass=f=1000",
  "-f",
  "s16le",
  "-ac",
  "1",
  "-ar",
  "44100",
  "-",
]);測り直すと、遅れていた語がほかにも見つかりました。どれも頭が「s」「sh」の摩擦音か、「t」の息の音で始まる語です。
語 | 母音の立ち上がり(直す前) |
|---|---|
six | 150ms |
seven | 160ms |
し | 110ms |
しち | 100ms |
sixteen | 75ms |
two・twelve | 65ms |
ten | 55ms |
これらも子音を 30ms までに詰め、英語と日本語の 32 語(1〜16 を 2 つの言語で)すべての母音の立ち上がりを 0〜30ms に収めました。
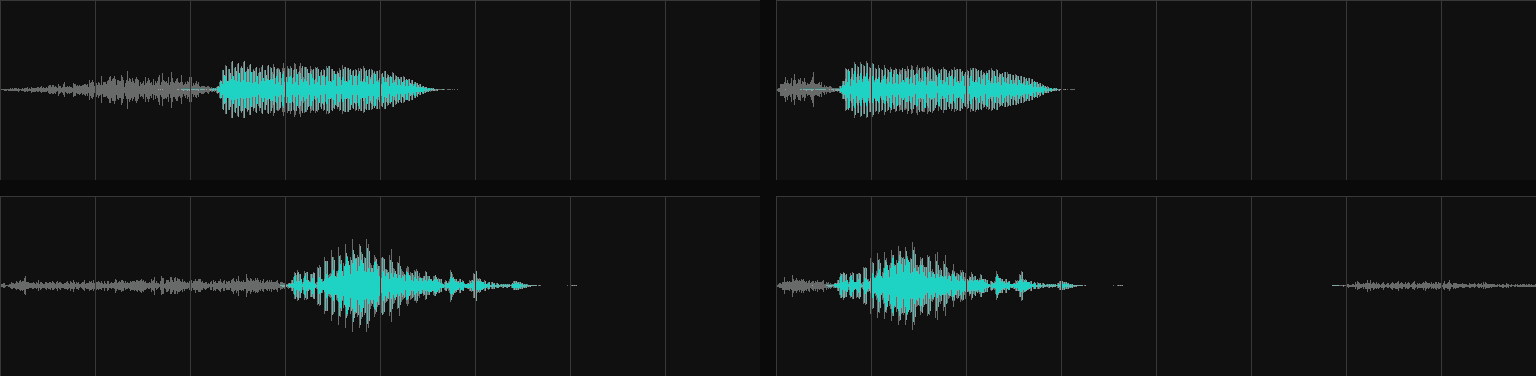
灰色は音全体、水色は 1kHz 以下の成分、縦線は 50ms ごとです。直す前は灰色の子音だけが長く続いてから水色の母音が始まっていましたが、直した後は、どちらも最初の縦線(50ms)より手前で母音が始まります。聞き比べると、遅れはかなり減りました。