複数の端末で同じ拍を鳴らす「SYNC ルーム」を作りました。ルームを作って人を招待すると、ルームに入った端末が、指揮者(ルームを作った人)の開始・停止とメトロノームの設定に合わせて鳴ります。バンドや吹奏楽、グループレッスンのように、同じ部屋でみんなで合わせて練習するときのための機能です。参加者はユーザー名で探して招待するので、使うにはサインインとユーザー名が必要です。
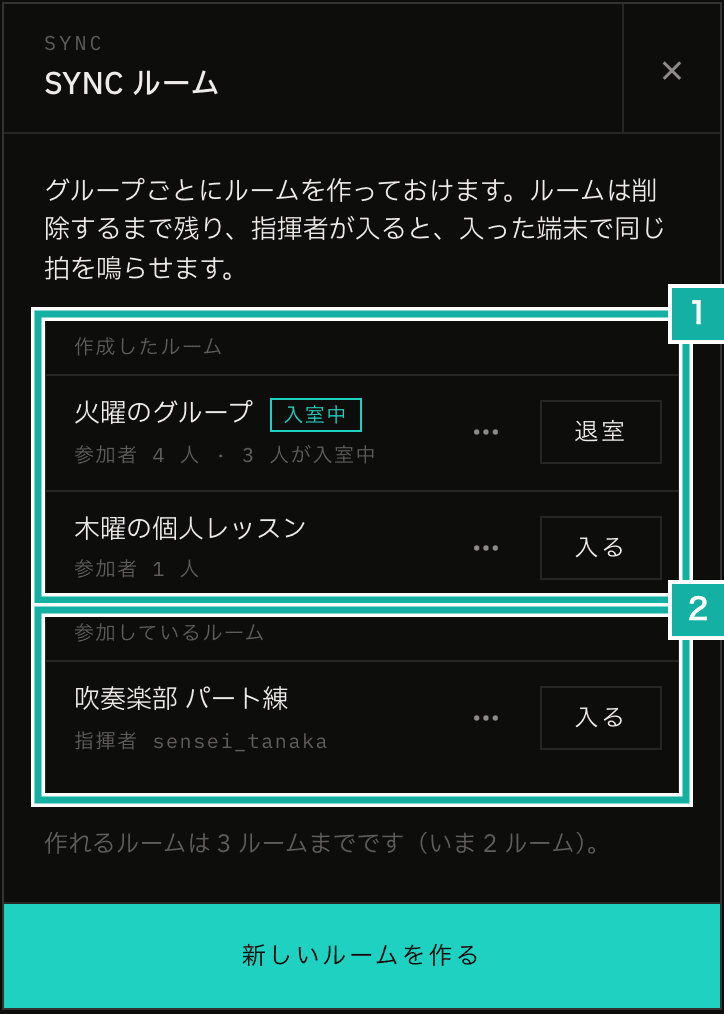
- 自分が作ったルーム。グループごとに作っておき、練習のたびに入る
- 招待されたルーム。指揮者の名前が出る
この記事では、専用のアプリを入れずに、ブラウザで端末どうしの拍をそろえる仕組みを書きます。拍の合図を送らずに開始時刻を共有する理由、サーバーの時計への合わせ方と、その推定を急に動かさない工夫、音を鳴らす時計への直し方、出力の遅れの補正、ルームの状態の届け方、見送った案の順です。
拍を送らず、開始時刻を共有する
指揮者が「いま鳴らして」と合図を送る形にすると、ネットワークの遅れがそのまま拍のずれになります。届くまでの時間は端末ごと・送るたびに違うので、毎拍送っても拍はそろいません。
そこで、どの端末も時計をサーバーの時計に合わせておき、指揮者は「この時刻に 1 拍目を鳴らす」という予定だけを共有する形にしました。各端末は約 1 秒ごとにこの予定を読みに行くので(後の節で書きます)、予定は全員が読み取れるよう 1.5 秒先の時刻にします。各端末は、その時刻を音を鳴らす時計(AudioContext の時刻)に直して、手元で拍を予約して鳴らします。
Metronome.fm の再生は、もともと開始時刻を起点に拍の位置が決まる作りでした。そのため、設定と開始時刻を共有すれば、どの端末でも同じ位置に拍が来ます。途中から入った端末は、過ぎた拍を鳴らさずに進めてから続きを鳴らすので、ほかの端末と同じ拍の位置から鳴ります。
サーバーの時計に合わせる
時計は、NTP と同じく往復の時間を測って合わせます。端末がサーバーに時刻を尋ね、サーバーが答えた時刻は、尋ねてから答えを受け取るまでのちょうど真ん中の時点の時刻だとみなします。
/**
 * 送った時刻 t0・サーバーが答えた時刻 t1・受け取った時刻 t2 から、1 回分のサンプルを作る。
 * 行きと帰りが同じ時間だったとみなし、サーバーの時刻 t1 を往復の真ん中に当てる
 */
export const toClockSample = (t0: number, t1: number, t2: number) => ({
  offset: t1 - (t0 + t2) / 2,
  rtt: t2 - t0,
  at: (t0 + t2) / 2,
});行きと帰りの時間が違うと、その差の半分が誤差になります。往復が短いほど、誤差の上限も小さくなります。
最初の試作では、指揮者の端末を時計の基準にし、Supabase Realtime の broadcast で時刻を尋ねました。broadcast は、届いたメッセージを相手の端末へ転送するだけで、サーバー自身は答えません。そのため、時刻を尋ねる行きと答えが返る帰りで、それぞれ中継を通ります。そこで、時刻だけを返す API を Vercel の関数として作り、時計の基準をサーバーにして測り直しました。
時計の基準 | 往復 | 時計の推定の幅 |
|---|---|---|
指揮者の端末(Supabase Realtime を 2 回通る) | iPhone 183〜185 ms | iPhone 18〜33 ms |
サーバー(Vercel の時刻の API) | Mac 40.5 ms・iPhone 43 ms | Mac 5.8 ms・iPhone 4.9 ms |
往復は約 4 分の 1、推定の幅は 4〜6 分の 1 になりました。サーバーの時刻には、NTP で合わせられた Date.now() を使います。Vercel の関数は呼ぶたびに別のインスタンス(サーバーの上で動く関数の実体)で動くことがありますが、どのインスタンスでも基準がそろうためです。
基準をサーバーにしたことで、指揮者の端末に頼らなくなりました。指揮者の端末も同じサーバーの時計に合わせるので、指揮者の画面がロックされても、ほかの端末は鳴らし続けられます。
時刻の API へのリクエストは、Clerk の認証を行う proxy(ページや API へのリクエストを先に受け取る Next.js の処理)を通さないようにしています。proxy を通すと往復が約 140 ms になったためです。
export const config = {
  matcher: [
    // 合奏の時刻の口(/api/ensemble/time)は、往復を短くするため通さない(拡張子の並びは省略)
    "/((?!_next|api/ensemble/time|[^?]*\\.(?:html?|css|js(?!on)|...)).*)",
    "/((?!api/ensemble/time)api.*)",
  ],
};推定を急に動かさない
最初の試作では、時計の推定が数分で約 8 ms 動き、その分だけ拍も動きました。往復の行きと帰りの差は、尋ねるたびに変わるためです。
これを抑えるため、推定のしかたを 2 つ変えました。
1 つめは、長めの期間のサンプルから、往復がとくに短いものだけを選ぶことです。使うのは、直近 3 分のサンプルのうち往復の短い 1 割だけです。端末とサーバーの時計は進み方がわずかに違うので、ずれは時間とともに変わります。選んだサンプルの時刻が 30 秒以上の幅に散らばっていれば、ずれの変わり方に直線を当てはめて、今のずれを求めます。
const recent = samples.filter((sample) => sample.at >= now - CLOCK_WINDOW_MS);
const count = Math.max(MIN_CLOCK_SAMPLES, Math.ceil(recent.length * BEST_RATIO));
const best = [...recent].sort((a, b) => a.rtt - b.rtt).slice(0, count);
const fit = span >= MIN_FIT_SPAN_MS ? fitLine(best, now) : null;
const offset = fit ? fit.intercept : median(best.map((sample) => sample.offset));2 つめは、鳴らすのに使うずれの値を少しずつしか動かさないことです。推定が変わっても、使う値を推定に近づけるのは 1 秒あたり 0.5 ms までにします。0.5 ms/秒なら、テンポは 0.05% しか変わりません。ルームに入った直後のように、使う値と推定が 30 ms 以上離れているときだけ、少しずつ近づけずに推定の値へ一度に切り替えます。
export const slewOffset = (current: number | null, target: number, elapsedMs: number) => {
  if (current === null || Math.abs(target - current) >= SNAP_THRESHOLD_MS) {
    return target;
  }
  const step = (MAX_SLEW_MS_PER_SECOND * elapsedMs) / 1000;
  return current + Math.max(-step, Math.min(step, target - current));
};時刻は、入った直後は 0.3 秒ごとに尋ねて早く合わせ、サンプルが 40 個集まったら尋ねる間隔を 1.5 秒に広げて、サーバーの関数を呼ぶ回数を減らします。
音を鳴らす時計に直す
開始時刻は、サーバーの時計での時刻です。前の節で求めたずれを使うと、これを端末の時計(performance.now())での時刻に直せます。ただ、音を予約するには、さらに AudioContext の時刻に直す必要があります。
これには getOutputTimestamp() を使います。このメソッドは、スピーカーからいま聞こえている音が AudioContext のどの時刻のものかと、それに当たる performance.now() の時刻を組で返します。そのため、出力の遅れを含めて 2 つの時計を対応づけられます。
export const contextTimeHeardAt = (context: AudioContext, perfMs: number) => {
  const stamp = context.getOutputTimestamp?.();
  if (stamp?.contextTime && stamp.performanceTime) {
    return stamp.contextTime + (perfMs - stamp.performanceTime) / 1000;
  }
  // 鳴り始める前や未対応のブラウザでは、報告された出力の遅れで近似する
  const reportedLatency = context.outputLatency || context.baseLatency || 0;
  return context.currentTime + (perfMs - performance.now()) / 1000 - reportedLatency;
};AudioContext の時計と端末の時計も進み方が少しずつ違うので、長く鳴らすと、始めたときの対応からずれていきます。このずれを見るため、5 秒ごとに、今の時計合わせで計算し直した 1 拍目の時刻と、実際に再生を始めた時刻を、どちらも AudioContext の時刻で比べます。ずれが 5 ms を 2 回続けて超えたら、同じ開始時刻から鳴らし直します。
出力の遅れは手で補正する
時計がそろっても、スピーカーから音が出るまでの遅れは端末ごとに違います。ブラウザが報告する outputLatency は当てにならないことが多く、Bluetooth では遅れがさらに大きくなります。
Mac と iPhone の 2 台を内蔵スピーカーで鳴らし、1 台のマイクで拾って測ったところ、iPhone の遅れはほぼ一定でした。
段階 | iPhone の遅れ(Mac に対して) | ばらつき |
|---|---|---|
補正なし | +22.4 ms | 1.4 ms(6 回) |
補正(17 ms)のあと | -2.5 ms | 0.1 ms(3 回) |
補正のあとの値が 22.4 − 17 = 5.4 ms にならず -2.5 ms なのは、測っているあいだに時計の推定が動いていたためです(「推定を急に動かさない」の節で書いた、最初の試作で推定が約 8 ms 動いた件)。
1 回合わせれば消せる遅れなので、自動で測る仕組みの前に、手で合わせる補正を用意しました。補正は指揮者の端末を基準(0)にし、メンバーの端末だけが「早く鳴らす」を 5 ms 刻みで直します。全員が補正を持つと、どの端末に合わせればよいかが決まらないためです。
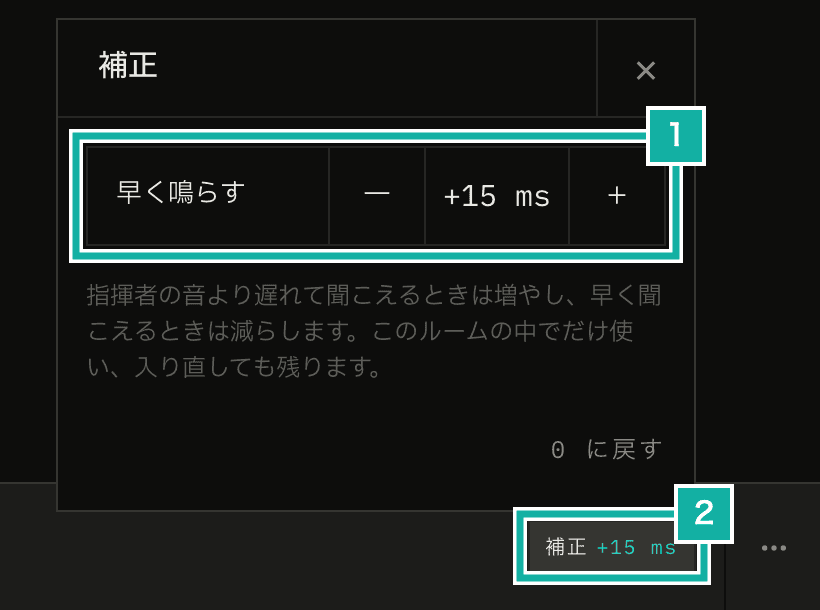
- 指揮者の音より遅れて聞こえるときは増やす。5 ms 刻みで ±500 ms まで
- 画面の下の帯のボタンに、今の補正の値が出る
補正はルームごとに端末の localStorage に残し、入り直しても使います。出力先の機器は練習の場所ごとに決まっていることが多いと考えたためです。
ルームの状態は 1 秒ごとに読みに行く
ルームの状態(鳴らしているか・開始時刻・設定)は Upstash の Redis に置き、メンバーの端末が約 1 秒ごとに読みに行きます。最初の節で書いた、指揮者が共有する予定(開始時刻)も、この状態の 1 つです。開始は 1.5 秒先の時刻を指すので、読みに行く間隔が 1 秒でも間に合います。
読みに行く先の API は、Server Action ではなく Route Handler にしました。Server Action は 1 つずつ順に処理されるので、1 秒ごとに呼ぶと、ほかの操作を待たせてしまうためです。
ルームの名前・参加者は DB に置き、作った人が削除するまで残します。1 秒ごとの読み出しで毎回 DB を読まないよう、Redis には DB の写しを置きます。ルームや参加者を変えたときは写しを消し、次に読みに来たときに DB から写し直します。
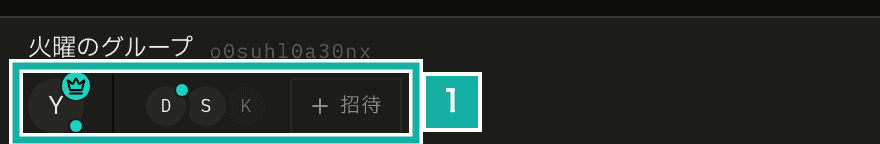
- 左端が指揮者(王冠)、右に参加者。点の付いた人は鳴らしている。薄く表示された人はルームにいない
端末は、1 秒ごとに状態を読みに行くうちの数回に 1 回、ルームにいることもサーバーに知らせます。そのときに鳴らしているかどうかも一緒に送り、鳴らす・止めるが変わったときはすぐに知らせます。帯のアバターの点は、この知らせをもとに付けたものです。
見送った案
- Supabase Realtime: 試作では使えましたが、前に書いたとおり、サーバーが時刻で答えられないので往復が長くなり、推定が動く原因にもなりました
- Cloudflare Durable Objects と WebSocket: ルームごとにサーバーの時計と状態を持てるので、往復はさらに縮む見込みでした。ただ、Vercel の関数で往復が約 40 ms まで縮んだので、Cloudflare の Worker を新しく作り、そのデプロイ・独自ドメイン・本番と開発の分け方まで用意するほどの差ではないと判断しました
- Vercel Functions の WebSocket: ルームの端末が別々のインスタンスにつながりうるので、ルームの状態を共有できません
離れた場所でのレッスンも対象から外しました。メトロノームの音は端末どうしでそろえられても、ビデオ通話の遅れ(100〜300 ms)があるので、互いの演奏はずれて聞こえるためです。
使い方は、マニュアルの「SYNC ルームで合わせて鳴らす」の章にまとめています。