Metronome.fm のフォーラムで、投稿を検索できるようになりました。検索の欄に空白で区切って入れた語を、すべて含む投稿を探します。探す先は、投稿の本文とスレッドの題です。
日本語の検索は、PostgreSQL の全文検索をそのまま使うとうまくいきません。この記事では、検索を PostgreSQL の拡張 pg_trgm を使った部分一致にした理由と、手元で測った速さ、Supabase と Prisma で索引を作るときに気をつけたことを書きます。
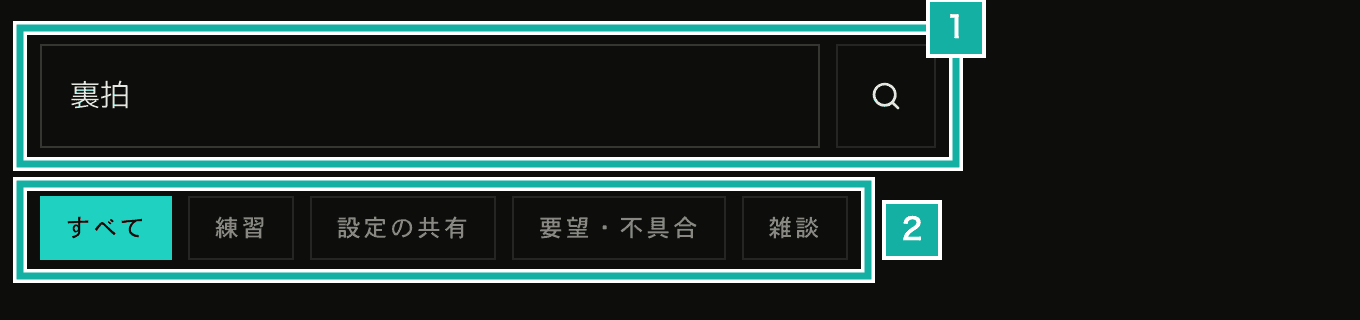
- 検索の欄。空白で区切ると、すべての語を含む投稿を探す
- カテゴリで絞る
全文検索は日本語を語に分けられない
PostgreSQL の全文検索(tsvector)は、文を空白や記号で語に分けてから索引を作ります。日本語は語のあいだに空白がないので、文がまるごと 1 つの語になります。
SELECT to_tsvector('simple', '裏拍だけ鳴らす設定で練習しています');
-- '裏拍だけ鳴らす設定で練習しています':1

SELECT to_tsvector('simple', '裏拍だけ鳴らす設定で練習しています')
    @@ to_tsquery('simple', '練習');
-- f「練習」で探しても、この投稿は見つかりません。日本語を語に分けるには、形態素解析(文を語に区切る処理)の辞書を持った拡張が要ります。
Supabase では、日本語に対応した全文検索の拡張 pgroonga も使えます。ただ、ブラウザを動かす自動テスト(E2E)は、手元の Docker と CI で立てる Postgres(postgres:15 のイメージ)で行っているので、pgroonga を使うには、どちらも pgroonga 入りのイメージに替える必要があります。そこで、テストの環境を替えずに済むよう、標準の Postgres に付いてくる拡張だけで作れる pg_trgm にしました。
pg_trgm とは
pg_trgm は、PostgreSQL に標準で付いてくる拡張(contrib)の 1 つです。CREATE EXTENSION pg_trgm で有効にすると、文字列を trigram(3 文字ずつの組)に分けて扱う関数と演算子が使えるようになります。索引でそれらを使うための演算子クラス(gin_trgm_ops など)も入ります。
trigram の作り方は、show_trgm で見られます。語の前に空白を 2 つ、後ろに 1 つ足し、1 文字ずつずらしながら 3 文字を切り出します。英字は小文字にそろえ、空白で区切った語ごとに作ります。
SELECT show_trgm('cat');
-- {"  c"," ca","at ",cat}

SELECT show_trgm('Click Track');
-- {" c"," t"," cl"," tr",ack,"ck ",cli,ick,lic,rac,tra}日本語も同じように切り出しますが、表示は 16 進の値になります。日本語のように 1 文字が複数バイトになる文字を含む trigram は、pg_trgm が 3 バイトのハッシュにして扱うためです。
SELECT show_trgm('三連符');
-- {0x0d64d3,0x4f2cac,0x66efe0,0xa9ebeb}
-- " 三"・" 三連"・"三連符"・"連符 " の 4 つを、ハッシュで表したものpg_trgm でできることは、大きく 2 つあります。1 つは、2 つの文字列がどれだけ似ているかを測ることです。similarity は共通する trigram の割合を 0〜1 で返し、% 演算子はそれがしきい値(既定は 0.3)以上かを返します。打ち間違いを許す検索に使えますが、フォーラムの検索では使っていません。
SELECT similarity('metronome', 'metoronome'); -- 0.61538464
SELECT similarity('metronome', 'drum'); -- 0もう 1 つは、LIKE・ILIKE・正規表現の検索を索引で速くすることです。GIN(gin_trgm_ops)か GiST(gist_trgm_ops)の索引を作ると、ILIKE '%三連符%' のように前に % が付いた部分一致でも索引が使えます。ふつうの B-tree の索引は、前に % が付いた部分一致には使えません。フォーラムの検索で pg_trgm を使うのは、この働きのためで、索引は GIN で作っています。
索引は、探す語の trigram をすべて含む行を候補として返します。trigram がそろっていても、語としてつながっているとは限りません。そのため PostgreSQL は、候補の行で元の条件をもう一度確かめます。EXPLAIN で出す実行計画(PostgreSQL がどう検索するかの計画)の Recheck Cond がその確認です。~~* は ILIKE のことです。
Bitmap Heap Scan on t (actual rows=1 loops=1)
  Recheck Cond: (body ~~* '%三連符%'::text)
  ->  Bitmap Index Scan on t_body_idx (actual rows=1 loops=1)
        Index Cond: (body ~~* '%三連符%'::text)
索引は速さのためのもので、検索の結果は変えません。索引がなくても、ILIKE は表の行を全部読んで同じ行を返します。
新しい投稿を保存すると、索引も一緒に更新されます。索引を作り直さなくても、新しい投稿が検索に出ます。
語に分けずに 3 文字の組で探すので、日本語でも英語でも同じ仕組みで探せます。ただし 2 文字の語には弱く、これは後の「手元で測った速さ」の節で書きます。
日本語が trigram になるかはロケールで変わる
日本語の文字が trigram になるかは、DB のロケール(言語や地域に合わせて文字の扱いを決める設定)で変わります。pg_trgm は文字か数字だけを trigram にしていて、ある文字が「文字」かどうかの判定がロケールに従うためです。検証用の Postgres に、ロケールの違う 2 つの DB を作り、同じ文の trigram を比べました。関数の前の extensions. は、拡張を入れたスキーマの名前です(後の「Supabase と Prisma で索引を作る」の節で書きます)。
-- ロケールが en_US.utf8 の DB
SELECT extensions.show_trgm('三連符の練習');
-- {0x0d64d3,0x4a13a8,0x4f2cac,0x6975c5,0xa9ebeb,0xdc990a,0xdd00eb}

-- ロケールが C の DB
SELECT extensions.show_trgm('三連符の練習');
-- {}C のロケールでは日本語の trigram が 1 つもできず、索引で絞れません(英数字は C でも trigram になります)。Supabase の DB は本番・開発とも en_US.UTF-8 だったので、そのまま使えました。
手元で測った速さ
手元の Mac の Docker(PostgreSQL 15.14)に、本文が平均 102 文字の投稿を 100,020 件入れ、ILIKE で探す時間を EXPLAIN ANALYZE で測りました。それぞれ 6 回測り、最初の 1 回を除いた 5 回の中央値です。索引の大きさは 18 MB で、表(31 MB)の 6 割ほどでした。
探した語 | 一致した件数 | 索引なし | 索引あり |
|---|---|---|---|
三連符(3 文字・一致が少ない) | 20 | 148.26ms | 0.07ms |
走ってしまう(6 文字・一致が多い) | 63,110 | 146.24ms | 146.06ms |
拍子(2 文字・一致が多い) | 62,855 | 145.89ms | 145.2ms |
一致する行が少ない語は、索引で 2000 倍ほど速くなりました。一方、6 割の行に当たる語では、プランナー(PostgreSQL の中で、どう検索するかを決める部分)が索引を使わず全件を読みました。ほとんどの行を読むなら、索引を引くより速いと見積もったためです。
2 文字の語も全件を読みました。%拍子% のように前後に % が付く部分一致では、語の前後に空白を足した組は使えません。2 文字からは 3 文字の組ができないので、索引で絞れません。日本語では「拍子」「裏拍」「練習」のような 2 文字の語で探すことが多いので、ここは pg_trgm の弱いところです。今のフォーラムは投稿が少なく、全件を読んでも困りません。投稿が増えたら、2 文字の語で探したときにかかる時間を確かめます。
Supabase と Prisma で索引を作る
DB の表や索引を変える SQL(マイグレーション)は、手で書きました。拡張は、extensions のスキーマ(DB の中で表や関数を分けて置く区画)に入れます。public に入れると、Supabase の Security Advisor が警告を出すためです。そのため、索引の演算子クラスもスキーマ付きで extensions.gin_trgm_ops と書きます。
CREATE SCHEMA IF NOT EXISTS extensions;
CREATE EXTENSION IF NOT EXISTS pg_trgm WITH SCHEMA extensions;

CREATE INDEX "forum_topics_title_trgm_idx" ON "public"."forum_topics"
  USING GIN ("title" extensions.gin_trgm_ops);
CREATE INDEX "forum_posts_body_trgm_idx" ON "public"."forum_posts"
USING GIN ("body" extensions.gin_trgm_ops);CREATE SCHEMA IF NOT EXISTS は、自動テストで使う標準の Postgres のために書いています。Supabase には extensions のスキーマが元からありますが、標準の Postgres にはありません。
SQL で作った索引は、Prisma の定義ファイル schema.prisma にも書きます。書かずにおくと、Prisma は次にマイグレーションを作るときに、schema.prisma にない索引として消そうとします。検証用の Postgres で prisma migrate diff を実行すると、2 つの索引を消す SQL が出ました。
-- schema.prisma に索引を書かなかったとき
DROP INDEX "public"."forum_posts_body_trgm_idx";
DROP INDEX "public"."forum_topics_title_trgm_idx";Prisma の @@index は、演算子クラスを raw() で書けます。
model ForumPost {
  // …
  @@index([body(ops: raw("gin_trgm_ops"))], type: Gin, map: "forum_posts_body_trgm_idx")
}schema.prisma の演算子クラスには、マイグレーションと違ってスキーマを付けていません。スキーマを付けなくても、prisma migrate diff でマイグレーションと schema.prisma を比べると、差分は出ませんでした(No difference detected.)。
検索の SQL
検索は Prisma の $queryRaw で書いています。語ごとに ILIKE の条件を作って AND でつなぎ、値は SQL の文に埋め込まず、すべてパラメータで渡します。
const termConditions = terms.map((term) => {
  const pattern = toForumLikePattern(term); // "%語%"
  return Prisma.sql`(p."body" ILIKE ${pattern} OR (t."title" ILIKE ${pattern} AND ${IS_FIRST_POST}))`;
});スレッドの題は、最初の投稿の一部として探します。題に語があれば、そのスレッドの最初の投稿が結果に出ます。IS_FIRST_POST は、同じスレッドにそれより前の投稿がない、という条件です。
語の中の % と _ は、ILIKE では何にでも一致する記号です。そのため \ を前に付け、文字そのものとして探します。LIKE で記号を文字として扱わせる印(エスケープの文字)は既定で \ なので、ESCAPE を書かなくても効きます。
export const toForumLikePattern = (term: string): string =>
`%${term.replace(/[\\%_]/g, (char) => `\\${char}`)}%`;削除した投稿とスレッド、通報や管理者の操作で非表示にした投稿とスレッドは、SQL の条件で結果から除いています。
結果には、本文のうち最初に見つかった語のあたりを抜き出し、語を太字にして出します。投稿は Markdown で書けるので、Markdown の記号を取り除いてから抜き出します。
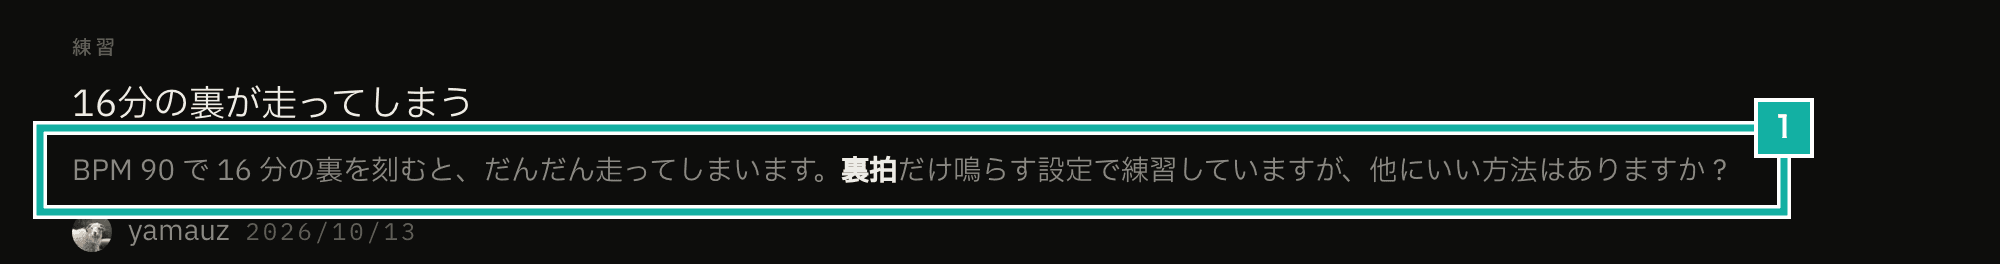
- 本文の抜粋。探した語を太字で示す
検索の回数とページ数に上限を付ける
検索は、サインインしなくても使えます。部分一致では、2 文字の語のように索引で絞れないことがあります。そこで、DB に負荷をかけすぎないよう、上限を 2 つ設けました。
- 1 分に検索できる回数を、利用者ごと(サインインしていなければ IP ごと)に 20 回までにする
- 結果のページは 50 ページ(1,000 件)までにする
ページの上限を設けたのは、後ろのページほど重くなるためです。結果から投稿のあるページへ飛べるよう、各件で「スレッドの何件目の投稿か」を数えています。この数える問い合わせは、OFFSET で読み飛ばす行の分も実行されます。1,000 件より先は出さないので、語を増やして絞り込んでもらう作りです。